
Les SDR passaient trop de temps à préparer la prospection : trouver des entreprises, des contacts, rédiger des messages, relancer à la main. J’ai construit un système semi-automatisé qui détecte, enrichit, score, assigne et suit des leads, de Scrapy à Microsoft Lists en passant par n8n et GPT-4o-mini.
Le problème
Le travail commercial n’était pas en cause, mais tout ce qui précède : trouver les entreprises et les bons contacts, comprendre leur contexte technique, écrire un message qui ne sente pas le template, relancer, suivre. Chaque tâche est faisable à la main, c’est pour ça qu’on tarde à l’automatiser.
L’objectif réel
Pas d’automatiser la prospection de bout en bout, mais de préparer un travail commercial plus propre, plus rapide et plus contextualisé. Les SDR gardent la main sur l’envoi, le suivi et les décisions commerciales.
Ce que j’ai construit
données → enrichissement → scoring → génération → interface SDR → suiviLes données de départ. Une API publique, la liste Tranco et des compilations sectorielles : plus de 50 000 sites d’entreprises françaises. Beaucoup sont inactifs ou hors cible, c’est prévu : la qualité vient après.
La détection de technos concurrentes. Un crawler Scrapy cherche dans le HTML, les scripts, les cookies, les headers et les meta tags des traces d’outils d’emailing, de CRM, de marketing automation et de billetterie (Mailchimp, HubSpot, Brevo, Salesforce, Splio, Sarbacane, Weezevent, etc.). Sur environ 50 000 sites, environ 10 000 entreprises utilisent une techno pertinente. La détection donne une probabilité, pas une certitude : scripts mutualisés, chargements dynamiques. → Comment fonctionne la détection en détail
L’enrichissement Hunter.io. Secteur, taille, pays, et contacts commerciaux liés au domaine. Le but n’est pas le volume : un mauvais contact fait perdre du temps au SDR.
Deux bases métier. Pour chaque techno concurrente, une liste de pain points (délivrabilité, support, coût, segmentation, intégrations…). Et une base de références clients (secteur, contexte, techno remplacée, problème résolu), pour que chaque message s’appuie sur une preuve crédible plutôt que « on a des clients dans votre secteur ».
Le scoring. Effectif (51 à 1000 salariés : +3), type d’organisation (entreprise publique ou organisme gouvernemental : +3, association : +2), nombre de contacts pertinents, techno concurrente prioritaire. Ce n’est pas une prédiction, c’est un outil de tri : quand tout est intéressant, plus rien ne l’est.
Le workflow n8n. Il trie par score, limite à 40 entreprises par semaine, écarte les doublons, assigne équitablement aux 3 SDR, ajoute pain points et référence client selon la techno et le secteur, génère un premier message et une relance, crée les lignes dans Microsoft Lists et notifie l’équipe dans Teams.
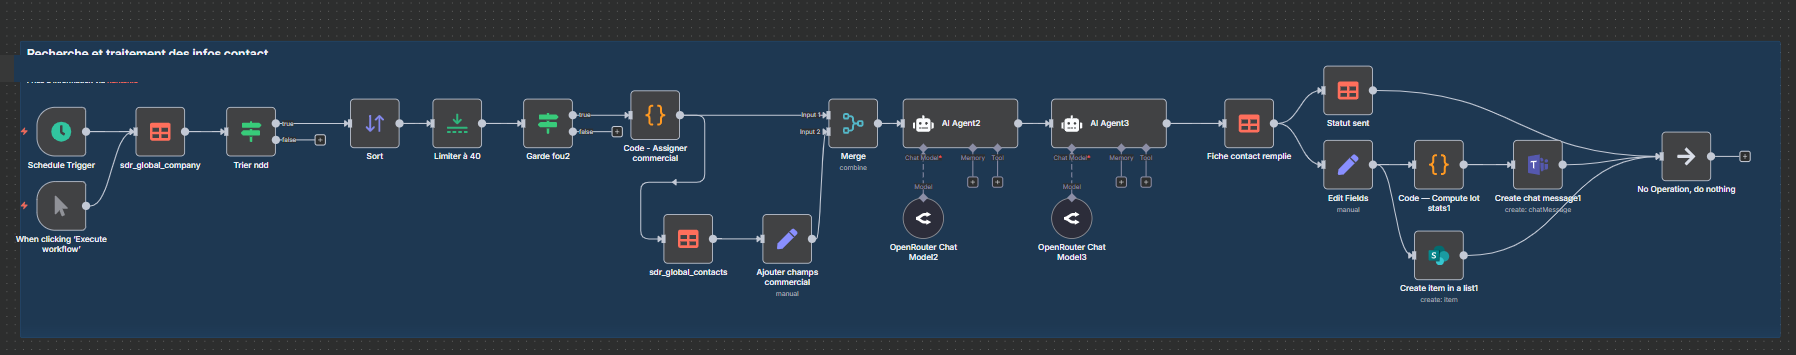
Pourquoi 40 par semaine ?
Ce n’est pas une limite technique. Un flux trop important dépasse la capacité réelle des SDR et finit ignoré. 40 entreprises bien préparées valent mieux que 200 mal suivies.
La génération. GPT-4o-mini via OpenRouter reçoit l’entreprise, la techno, ses pain points, la référence choisie et les contraintes de ton. Il formule, il ne décide pas qui contacter ni avec quel argument : ça, c’est la logique métier du workflow. Pour de la rédaction à volume, son rapport coût/performance est très bon.
L’interface SDR. Une Microsoft List partagée, une ligne par entreprise avec contacts, messages et statuts (prospect, email, commercial). Pas glamour, mais filtrable et déjà dans l’écosystème des SDR. Power Automate gère la vie de chaque lead : passage en_cours, bascule non_repondu après 5 jours, détection de réponse, clôture dès qu’un statut commercial est saisi, rappels de relance.
Le reporting. Un tableau Power BI rend le système pilotable : ajuster le scoring, les seuils, comparer les commerciaux. Sur la période de lancement :
| KPI | Valeur |
|---|---|
| Leads total | ~2 000 |
| Leads en cours | 270 |
| Leads clos | 62 |
| Refus | 7 |
| Erreurs email | 26 |
| Hors cible | 31 |
Ce qui a cassé
- Les données web sont sales : erreurs, redirects, HTML cassé, sites vides. Il a fallu des étapes de nettoyage non prévues.
- Hunter.io ne connaît pas tous les domaines : peu ou pas de données, des 404, à gérer sans bloquer le pipeline. J’aurais dû définir une stratégie dès le départ (retry, mise en attente, exclusion).
- Les signatures Scrapy vieillissent : un concurrent change de CDN ou renomme ses scripts, et la détection rate. Elle n’est jamais finie.
- L’alignement humain a été le plus difficile : faire adopter aux SDR les statuts, les règles de gestion et la façon de lire des leads générés automatiquement.
C’est pour ça que la notification Teams compte autant que le code : nombre de leads, répartition par commercial, consignes sur les statuts et les relances, lien vers la liste.
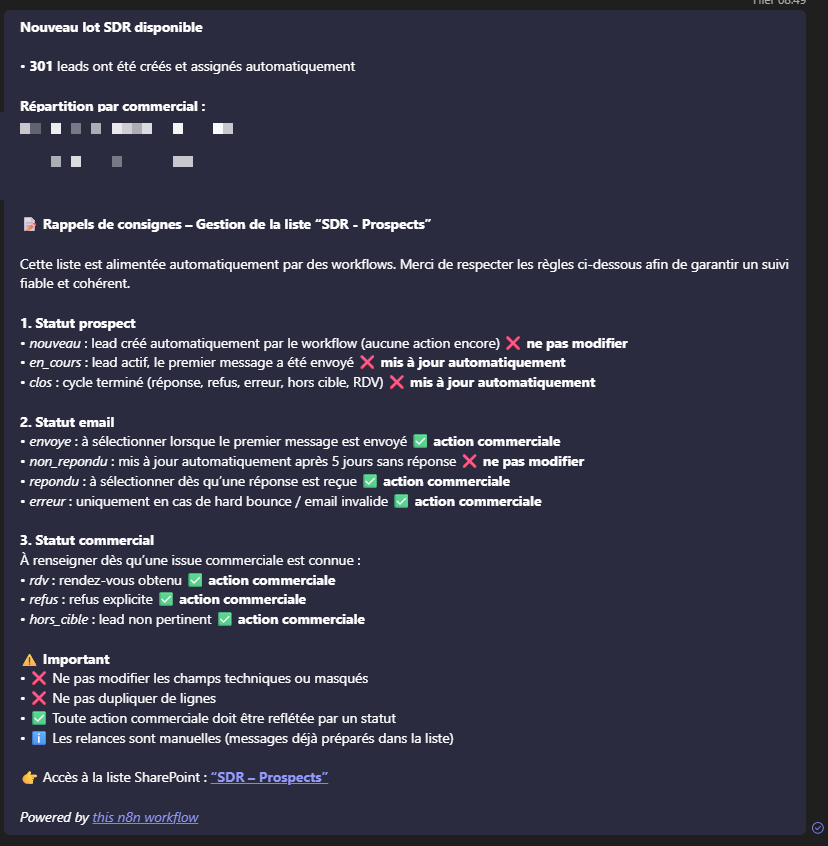
Si c’était à refaire : normaliser les données plus tôt (casse, encodages, doublons de domaines), ajouter logs structurés et alertes dès le départ, et découper le workflow en sous-workflows avant qu’il devienne dense.
À retenir
Je pensais construire un outil de prospection. J’ai surtout construit un assemblage : données, règles métier, scoring, génération et interface opérationnelle. Chaque brique est simple, c’est l’assemblage qui crée la valeur, et un outil sans consignes claires finit abandonné.