
Pour ma prospection, j’ouvrais des sites un par un pour deviner leur stack marketing. J’ai construit avec Scrapy un moteur qui détecte ces technologies sur des milliers de domaines, en cumulant des signaux plutôt qu’en cherchant un mot dans le HTML.
Le problème
Inspecter le code source, regarder les scripts chargés, chercher les tags marketing : je refaisais ça à la main pour chaque entreprise. Or un site en dit beaucoup :
| Signal détecté | Ce que ça raconte souvent |
|---|---|
| Klaviyo | Stack e-commerce moderne |
| HubSpot | Logique inbound / CRM |
| Segment | Culture data |
| GTM très chargé | Tracking devenu difficile à maintenir |
| Absence de CMP | Faible maturité RGPD |
Les outils existants ne convenaient pas :
| Outil | Problème principal | |
|---|---|---|
 |
BuiltWith | Fermé, pas d’API exploitable proprement, cher à grande échelle |
 |
Wappalyzer | Orienté extension navigateur, peu adapté à l’automatisation |
Surtout, je voulais comprendre comment la détection fonctionnait : ajouter mes signatures, analyser les faux positifs, brancher le tout dans d’autres systèmes. Le tout a démarré sur mon PC Windows, avec Python, Scrapy et quelques JSON.
D’un if à un faisceau de signaux
La première version tenait en deux lignes :
if "hubspot" in html:
    print("HubSpot détecté")
Puis sont arrivés les scripts injectés dynamiquement, les CDN mutualisés, les technos visibles seulement via cookies, les frameworks JS qui renvoient un HTML presque vide. La question est devenue : est-ce que plusieurs éléments indépendants suggèrent fortement HubSpot ?
flowchart TD
    A[Liste de domaines] --> B[Spider Scrapy]
    B --> C[HTML] & D[Scripts] & E[Headers] & F[Cookies] & G[Meta tags]
    C & D & E & F & G --> H[Moteur de signatures]
    H --> I[Scoring]
    I --> J[Technologies détectées]
    J --> K[Export JSON] & L[Supabase] & M[n8n workflows]
Scrapy ne détecte rien : il collecte les signaux, la logique est ailleurs. Je l’ai choisi parce qu’il tient plusieurs centaines de pages/minute en local sans rendu JS, avec retries, throttling, concurrence et pipelines inclus. Playwright seul était trop lourd, Selenium trop lent, requests + BeautifulSoup bon pour du ponctuel seulement.
Les signatures et le scoring
Une signature de la première version, c’était "html": "hubspot" : faux positifs en masse, aucune notion de confiance. Aujourd’hui, chaque techno combine plusieurs types de preuves :
{
  "name": "Klaviyo",
  "html": ["klaviyo"],
  "script": ["static.klaviyo.com"],
  "cookies": ["__kla_id"],
  "confidence": { "html": 0.10, "script": 0.30, "cookie": 0.45 }
}
Le scoring additionne les poids, plafonné à 1.0. Un cookie est très fiable (il faut l’avoir installé), un script CDN fiable mais parfois mutualisé, un mot dans le HTML peut venir du contenu éditorial. J’ai testé des approches plus statistiques : elles rendaient surtout le système plus difficile à déboguer. Je suis resté sur un scoring lisible.
Résultat sur un domaine : Shopify à 0,97 (cdn.shopify.com, _shopify_y, shopify-checkout), Klaviyo à 0,91 (static.klaviyo.com, __kla_id). De quoi scorer la maturité tech d’une entreprise, construire des ICP ou suivre des changements de stack.
Ce qui a cassé
Le JavaScript moderne
Sur certains sites Next.js, Scrapy récupérait littéralement <div id="__next"></div> : tout le reste arrivait après hydration, et certaines technos devenaient invisibles. Le compromis : un fallback Playwright conditionnel, déclenché seulement si la détection est insuffisante.
| Mode | Pages/min (approx.) | RAM |
|---|---|---|
| Scrapy seul | ~300-400 | Faible |
| Scrapy + Playwright | ~20-50 | Élevée |
Le plus dur n’était pas le code mais de décider quand déclencher le fallback, sur quels domaines et avec quels timeouts. C’est l’arbitrage le plus important du projet, et il reste difficile à scaler.
Les données sales et les faux positifs
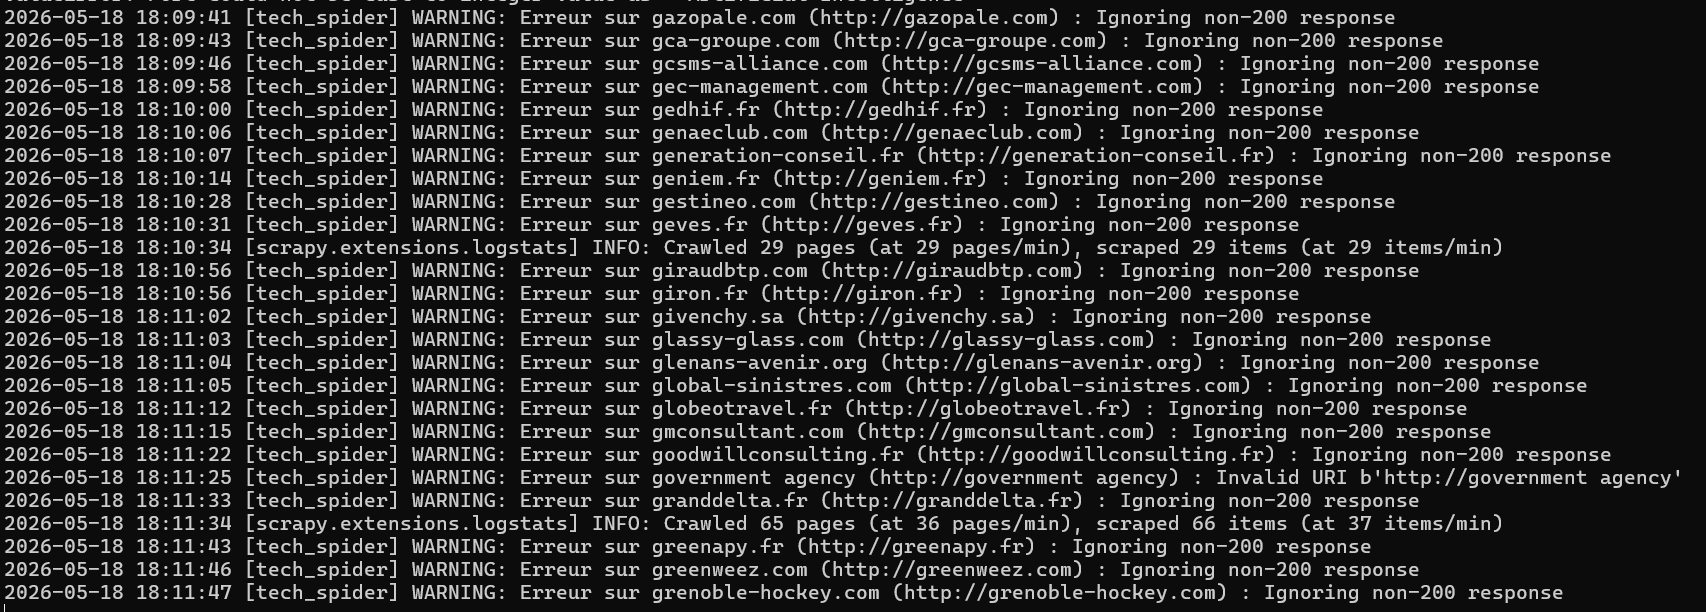
Redirects absurdes, certificats invalides, timeouts, anti-bot, HTML cassé, encodages étranges : la gestion des cas limites prend plus de temps que la logique métier.
Les faux positifs
Le mot segment peut désigner Segment CDP, un mot du contenu ou un slug d’URL. Même problème avec les CDN mutualisés (Cloudflare, jsdelivr, Google APIs). Détecter moins de technos avec des signaux fiables vaut mieux.
Après plusieurs milliers de domaines : beaucoup de sites à moitié cassés, beaucoup plus de WordPress que prévu, des stacks très répétitives par secteur, et des dizaines de scripts morts hérités.
Ce que je referais autrement
Mes signatures ont fini en signatures.json, signatures_v2.json, signatures_final_final.json. Je les rangerais aujourd’hui par catégorie (/crm/hubspot.json, /marketing/klaviyo.json…) avec validation dès le départ. Et j’ai trop longtemps testé à la main sur des domaines au hasard : il faut une liste de domaines de référence à stack connue, des snapshots HTML et des tests de régression, car une techno peut changer de CDN ou de script du jour au lendemain.
À retenir
Je pensais construire un détecteur de technos ; j’ai surtout construit un système de collecte de signaux web, qui ne voit que ce qui fuite côté frontend (le backend et l’infra restent invisibles). Un pipeline compréhensible et stable vaut mieux qu’un système « intelligent » impossible à maintenir.