
Pour Signar, j’ai construit un pipeline n8n qui surveille les concurrents d’une équipe commerciale sur Trustpilot, LinkedIn et leurs sites web, puis transforme ces données publiques en signaux commerciaux scorés. L’objectif : éviter deux heures de recherche manuelle par semaine. La leçon : trouver les données est facile, les rendre utiles ne l’est pas.
Le problème
La veille commerciale est manuelle, discontinue et difficile à tracer. Quand un concurrent recrute massivement ou accumule des avis négatifs sur son support, le signal est public, mais il faut le capter à temps et décider s’il mérite une action.
Les outils existants (alertes Google, social listening, market intelligence) sont trop généralistes, fermés, chers au-delà de 20 entreprises surveillées et bruités. Je voulais contrôler les sources, le filtrage, le format de sortie et la place de l’IA.
Ce que j’ai construit
Une boucle par concurrent : collecte sur trois sources, nettoyage, assemblage d’un contexte structuré, analyse IA, déduplication, stockage dans Supabase, puis priorisation.
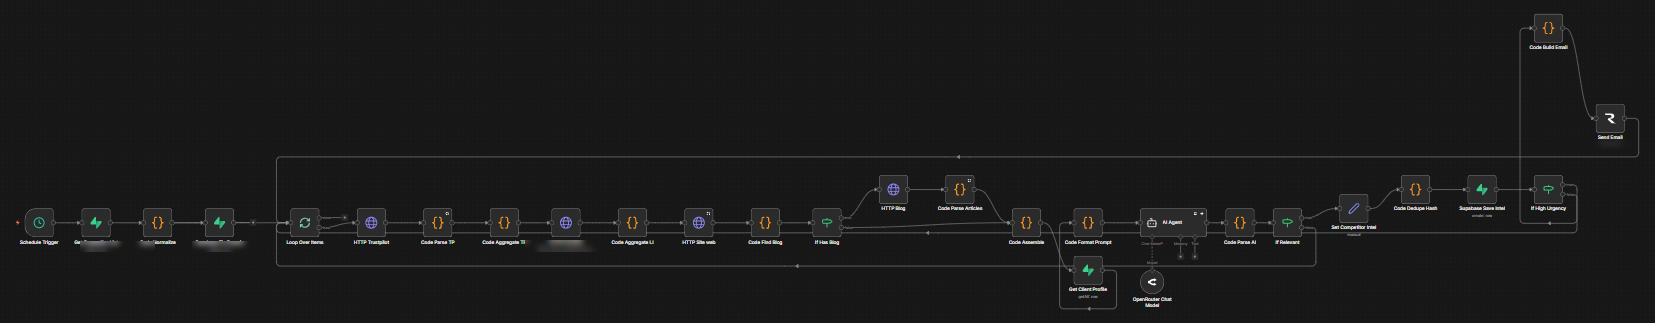
n8n orchestre, il ne traite pas : la logique métier est dans les nœuds de transformation, les appels HTTP et le prompt.
Les trois sources :
| Source | Ce qu’elle apporte | Difficulté | Bruit |
|---|---|---|---|
| Trustpilot | Douleurs client directes (support, prix, onboarding) | Moyenne | Moyen |
| Mouvements : partenariats, recrutements, lancements | Élevée | Très élevé | |
| Site web | Discours officiel et son évolution (pricing, offre, cible) | Moyenne | Moyen |
Les choix techniques :
- Supabase stocke la liste des concurrents et les signaux (source, type,
severity,confidence, angle commercial, action recommandée, hash, dates). - OpenRouter donne accès à plusieurs modèles : Claude pour le raisonnement, GPT-4o-mini pour la classification à volume.
- Apify pour LinkedIn : une dépendance payante, mais moins coûteuse que maintenir un scraper face aux protections anti-bot, pour un crawl hebdomadaire.
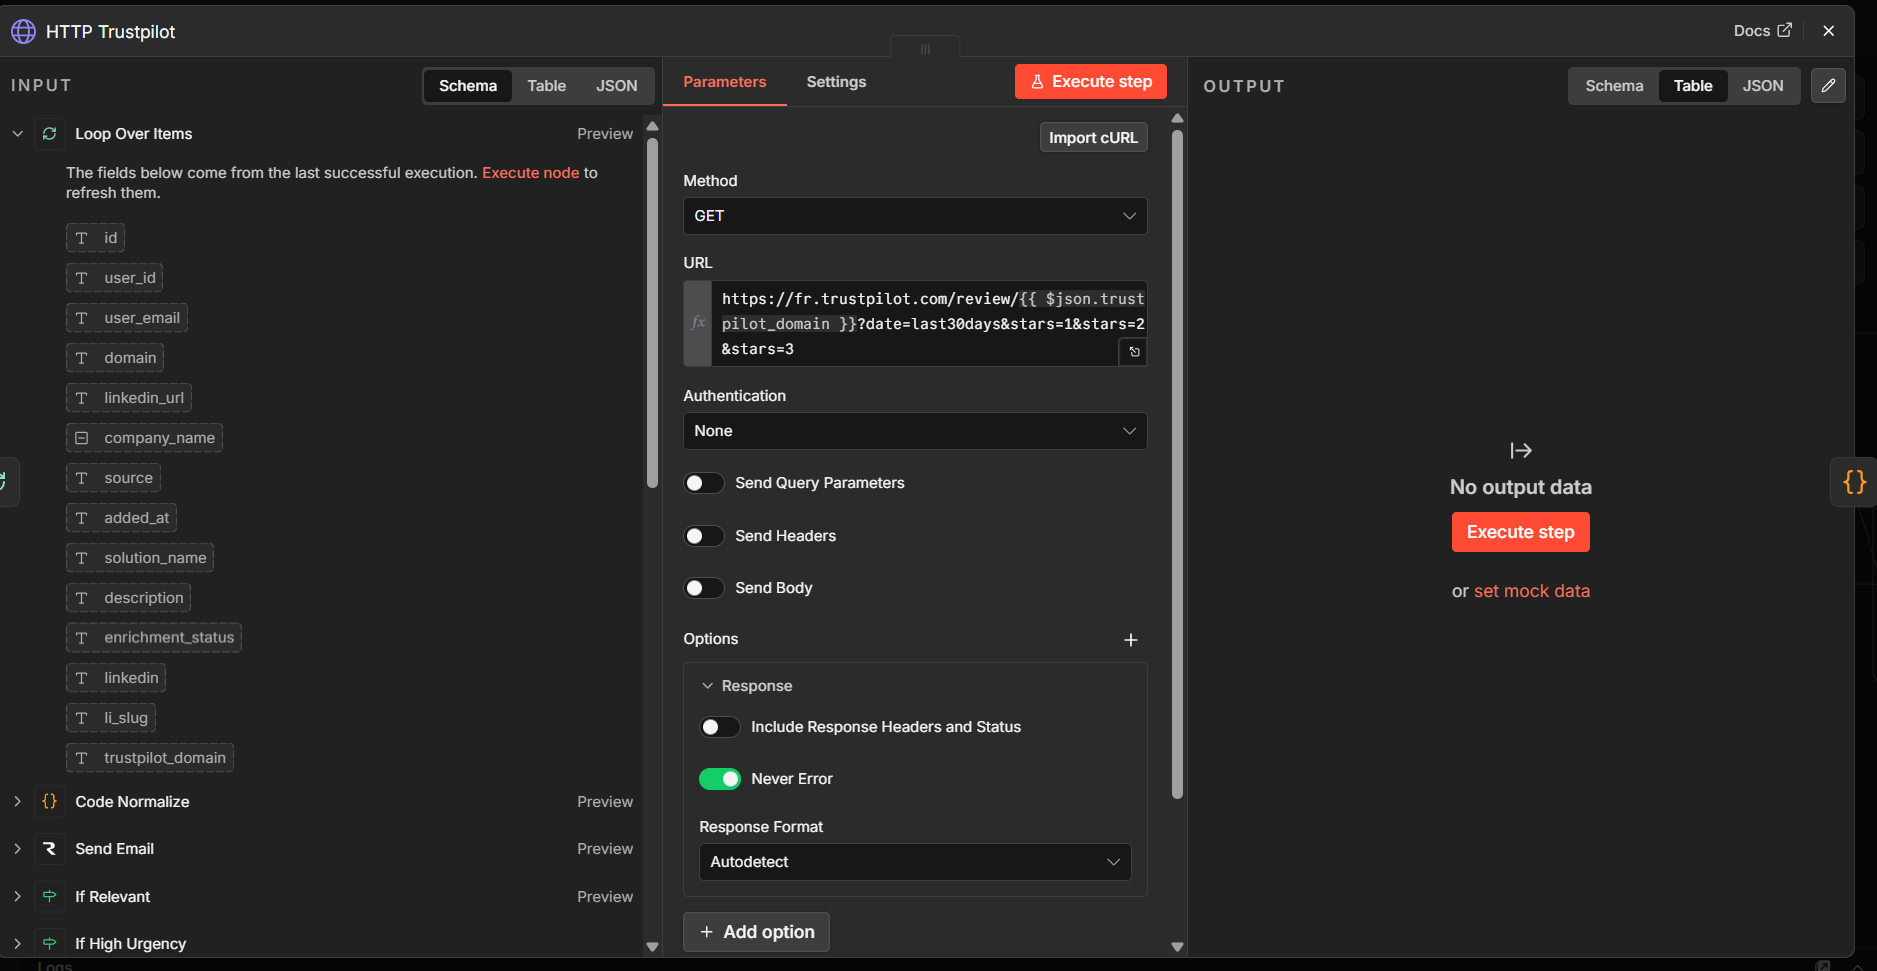
- HTTP natif n8n pour Trustpilot et le web, avec un fallback de rendu JavaScript uniquement si la page semble vide, comme dans le projet Scrapy de détection de technologies.
Quelques étapes qui comptent :
- Normalisation des domaines en entrée de boucle. Un
wwwou unhttpsmal géré casse les appels HTTP plus loin : mieux vaut rejeter l’entrée tôt. - Filtre LinkedIn avant l’IA. J’écarte les félicitations internes, la marque employeur, les partages sans contenu et l’événementiel. Je garde lancements, recrutements ciblés, partenariats et changements de direction.
- Chemins standards pour le web (
/blog,/news,/ressources,/changelog…), testés dans l’ordre jusqu’à trouver du contenu lisible. - Nettoyage systématique : balises, scripts, navigation, footer, doublons, encodages, troncature au-delà d’un seuil de tokens.
- Contexte en blocs séparés (Trustpilot, LinkedIn, site web, profil client) et sortie JSON stricte. Le modèle confond moins les sources.
- Hash anti-doublon sur domaine, source, type de signal et les 200 premiers caractères du contenu. Sans lui, le même avis de trois mois revient à chaque crawl.
- Score d’urgence
severity×confidence: au-dessus de 0,6, notification Teams ou Slack, sinon revue hebdomadaire.
Chaque signal sort avec un angle commercial (« mettre en avant la qualité du support ») et une action recommandée (« préparer une démo centrée sur le support »), directement exploitables dans un CRM ou un email de synthèse.
Ce qui a cassé
Trop de confiance dans l’IA. Ma première version envoyait le HTML brut au modèle en lui demandant de « trouver les signaux intéressants ». Résultat imprévisible, coûteux et souvent inutile.
Le modèle est aussi bon que ce qu’on lui donne
Le même prompt produit une réponse confuse sur du HTML brut et une sortie exploitable sur un contexte propre. Le nettoyage en amont est la vraie variable d’ajustement.
Le bruit LinkedIn. Sur 100 posts récupérés pour une entreprise, j’en gardais parfois 3 ou 4. Le filtre pré-IA par pattern a réduit les coûts et accéléré le traitement.
Les sites en JavaScript. Un concurrent avait une page /blog qui ne renvoyait qu’un shell JS. Le modèle a consciencieusement analysé « Loading… Please enable JavaScript. » comme du contenu éditorial. Le fallback Playwright règle ça, mais ralentit nettement cette branche.
Le workflow obèse. Après quelques semaines, plus de 60 nœuds. Je l’ai découpé : un workflow principal pour la boucle, un sous-workflow par source, chacun testable seul.
Trop de signaux. Certaines versions remontaient 40 signaux par semaine et par entreprise. Personne ne les lisait. En garder 3 à 5 vraiment utiles a changé l’adoption.
Ce qui a marché
Le croisement des sources. Un cas observé : plaintes Trustpilot sur le temps de réponse du support sur 30 jours, recrutements Customer Success et Support sur LinkedIn, et un article « Comment nous améliorons notre support client » sur le site. Séparément, c’est anecdotique. Ensemble, c’est une entreprise en tension opérationnelle, et un angle à transmettre à un commercial.
Les signaux répétés valent plus que les spectaculaires : la même plainte 8 fois en 3 semaines est un pattern, que le pipeline agrège.
Sur la répartition indicative des signaux exploitables : Trustpilot 42 %, site web 35 %, LinkedIn 23 %.
Limites et ce que je referais
Le scoring reste heuristique (seuils calibrés à la main), LinkedIn dépend d’un acteur Apify, Trustpilot ne donne rien sous 10 avis, il n’y a ni historique de tendance ni boucle de validation humaine.
Je referais trois choses autrement : définir le schéma de signal avant le premier prompt (chaque changement touchait prompt, parsing, table et affichage), structurer les workflows en sous-workflows dès le départ plutôt que d’empiler des v2_final_corrigé.json, et créer un jeu de test fixe d’entreprises aux signaux connus pour mesurer chaque modification.
À retenir
La donnée publique est abondante, la valeur vient du tri. L’IA classe, résume et contextualise, mais seulement après la collecte, le nettoyage et la structuration. Un commercial ne veut pas lire des données : il veut savoir pourquoi agir maintenant et quoi dire.